Cómo una IA reconstruye lo que una persona está viendo a partir de un escaneo cerebral
Brain-IT, un modelo del Weizmann Institute, genera una imagen aproximada de lo que una persona mira a partir de su actividad cerebral medida con fMRI. Funciona con imágenes fijas y después de entrenarse con miles de ejemplos: no lee la mente.
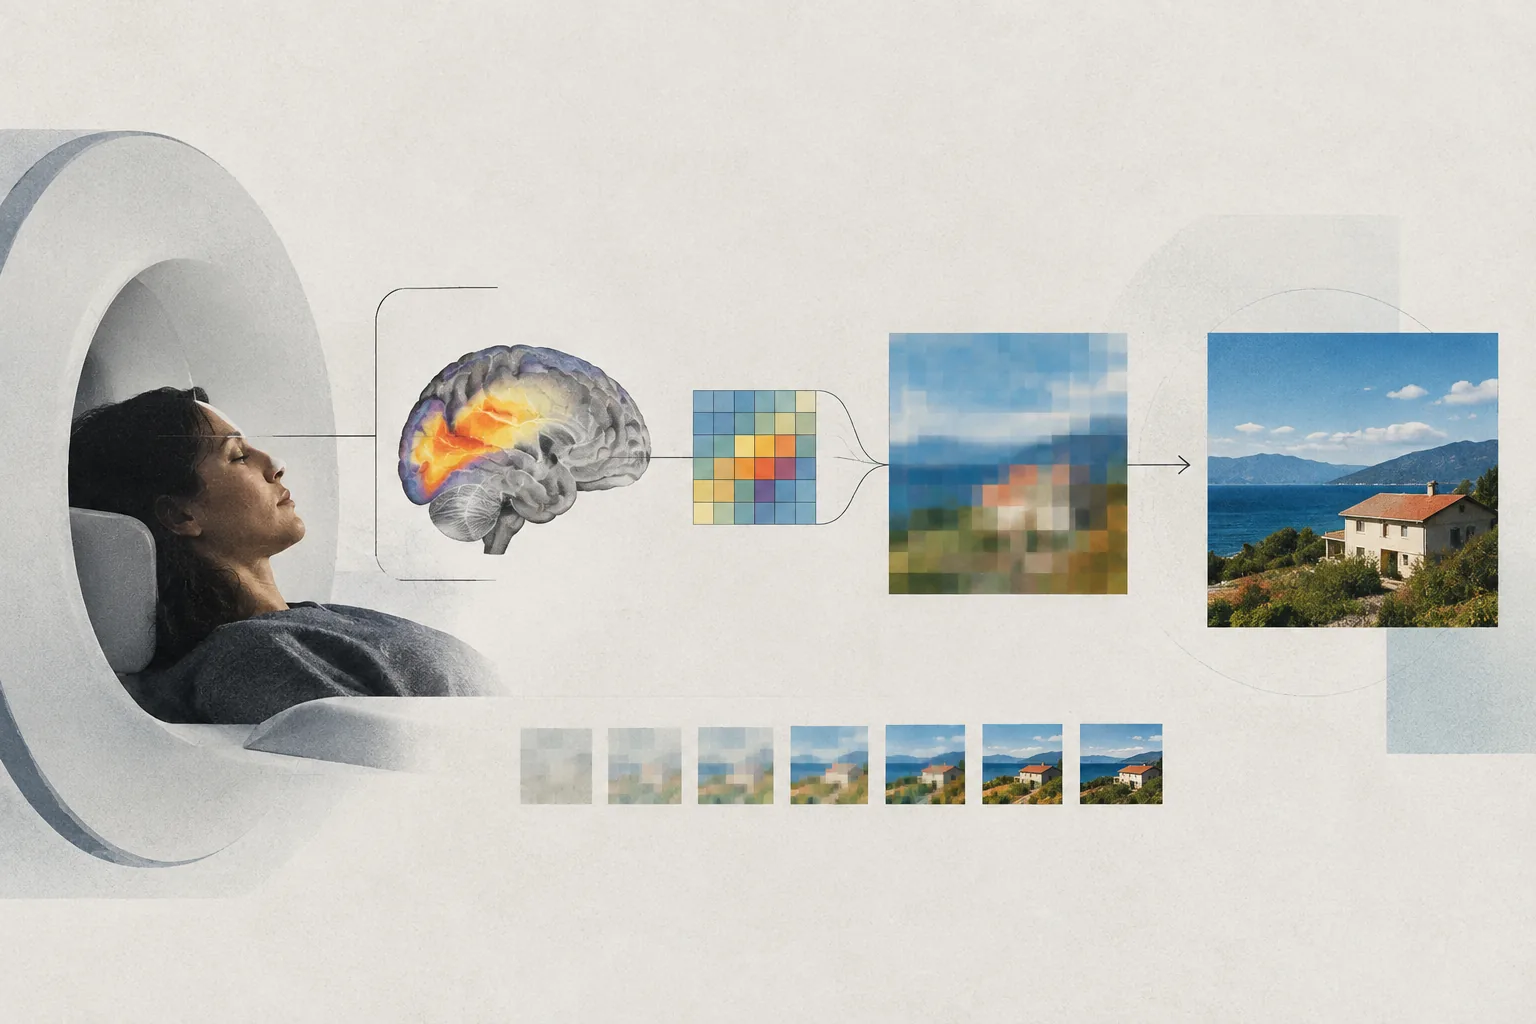
Una inteligencia artificial puede generar una imagen aproximada de lo que una persona está mirando a partir de su actividad cerebral registrada con fMRI. El resultado puede conservar objetos, colores y parte de la composición de la escena: por ejemplo, una persona ubicada a un lado de una cancha, un automóvil frente a un paisaje o un animal dentro de una habitación.
La tecnología se llama Brain-IT y fue desarrollada por investigadores del Weizmann Institute of Science. El trabajo fue presentado en ICLR 2026 y utiliza una arquitectura llamada Brain Interaction Transformer, o BIT. El modelo no “lee la mente” en un sentido general: reconstruye imágenes estáticas que los participantes están observando durante un experimento, después de haber sido entrenado con datos de actividad cerebral e imágenes.
La diferencia es importante. El sistema no recupera cualquier pensamiento, recuerdo o imagen imaginada. Tampoco funciona como una cámara conectada directamente al cerebro. La fMRI registra cambios indirectos y lentos asociados con la actividad neuronal, y la IA transforma esos patrones en una imagen plausible mediante varios pasos intermedios.
La señal cerebral no contiene una fotografía
La resonancia magnética funcional mide cambios en el flujo sanguíneo y en la oxigenación del cerebro. Cuando una región trabaja más, suele producirse una variación en la cantidad de sangre oxigenada que recibe. Esa señal, conocida como BOLD, permite estimar qué zonas del cerebro están activas, pero no registra directamente la actividad de cada neurona ni almacena una copia visual de lo que la persona ve.
Los datos se dividen en pequeños cubos tridimensionales llamados vóxeles. Cada vóxel representa una porción del cerebro y contiene una señal que cambia durante el experimento. En el conjunto de datos utilizado por Brain-IT, los investigadores trabajaron con alrededor de 40.000 vóxeles vinculados principalmente con el procesamiento visual.
La fMRI ofrece una resolución espacial relativamente buena, pero es lenta. En el Natural Scenes Dataset, la señal se muestrea aproximadamente cada 1,6 segundos, mientras que la experiencia visual cambia mucho más rápido. Por eso el problema es especialmente difícil para videos o escenas dinámicas. Brain-IT se concentra en imágenes estáticas.
El entrenamiento relaciona imágenes con patrones cerebrales
Para que el sistema aprenda, primero necesita ejemplos en los que conozca las dos partes del problema: la imagen que estaba viendo una persona y la respuesta cerebral registrada mientras la observaba.
Los investigadores utilizaron el Natural Scenes Dataset, que contiene datos de ocho adultos que miraron miles de imágenes naturales durante entre 30 y 40 sesiones de escaneo. En total, el conjunto reúne unos 73.000 pares de imagen y actividad cerebral. Las imágenes provienen de la base MS COCO y muestran escenas cotidianas, personas, animales, objetos y paisajes. El NSD describe sus datos y condiciones experimentales.
Durante el entrenamiento, la IA busca regularidades. Aprende, por ejemplo, que ciertos patrones distribuidos por la corteza visual suelen aparecer cuando hay determinados colores, formas, posiciones u objetos. No aprende una regla simple como “esta zona equivale a un perro”. La información visual está repartida entre muchas regiones y cada una puede contribuir a varias características de la escena.
Además, el cerebro de una persona no responde exactamente igual que el de otra ante la misma imagen. Las diferencias anatómicas no son el único problema: también hay diferencias funcionales. Una región que cumple cierto papel en un participante puede estar ubicada en una posición algo distinta en otro.
La IA agrupa vóxeles por función
Para resolver esa variabilidad, Brain-IT no se limita a alinear los cerebros por su anatomía. Organiza los vóxeles según la similitud de sus respuestas y los reúne en 128 grupos funcionales compartidos entre los participantes.
Esto significa que dos vóxeles pueden pertenecer al mismo grupo aunque no estén en la misma posición anatómica. Lo que importa es que respondan de forma parecida ante determinados aspectos de las imágenes.
Esta estrategia deriva de un trabajo anterior del mismo equipo, llamado Universal Brain Encoder. Ese modelo aprende una representación individual para cada vóxel y la relaciona con características visuales de las imágenes. Para ello utiliza un mecanismo de atención que permite que cada vóxel “consulte” las partes de la imagen más relevantes para explicar su respuesta. El trabajo del Universal Brain Encoder está disponible en arXiv.
En Brain-IT, los grupos funcionales actúan como unidades intermedias. En lugar de procesar una lista enorme de señales independientes, el sistema trabaja con resúmenes de grupos que podrían desempeñar funciones visuales similares en distintas personas.
El Brain Interaction Transformer combina esas señales
El núcleo de Brain-IT es el Brain Interaction Transformer. Su tarea es transformar los patrones de actividad de los grupos funcionales en características visuales.
Primero, cada grupo de vóxeles se convierte en un vector llamado brain token. Un token es una representación numérica compacta: resume la información relevante de una parte del cerebro.
Después, el modelo utiliza dos mecanismos de atención:
- La self-attention permite que los grupos cerebrales intercambien información entre sí.
- La cross-attention permite que el modelo use esos grupos para predecir características específicas de la imagen.
El segundo punto es central. Muchos sistemas anteriores intentaban traducir toda la actividad cerebral a una representación global, algo parecido a describir la imagen como “un paisaje con una persona”. Brain-IT intenta predecir características asociadas con distintos parches o regiones de la imagen. Así puede conservar mejor no solo qué objetos aparecen, sino también dónde están ubicados.
La arquitectura busca representar el carácter distribuido de la visión: el cerebro no procesa el color, la forma, la posición y el significado en un único punto aislado, sino mediante redes de regiones que interactúan.
Dos ramas separan el contenido de la estructura
Brain-IT no utiliza una única representación visual. Predice dos tipos de características complementarias.
La primera captura información semántica, es decir, el contenido de la escena. Está basada en representaciones derivadas de CLIP, un modelo entrenado para relacionar imágenes con palabras. Esta rama ayuda a determinar si la imagen contiene una persona, un animal, una cancha, una habitación o un automóvil.
La segunda captura información estructural y de bajo nivel. Utiliza características relacionadas con VGG, una red que representa bordes, formas, texturas y disposición espacial. Esta rama ayuda a preservar la composición, el color y la geometría general.
La separación responde a un problema habitual de los modelos generativos. Un modelo de difusión puede producir una imagen muy realista aunque no respete con exactitud la imagen original. Si recibe una señal cerebral débil que apenas indica “hay una persona en un parque”, puede completar el resto con una escena plausible, pero colocar a la persona en el centro, cambiar el color de la ropa o eliminar objetos del fondo.
La rama estructural intenta reducir ese margen de invención.
Una reconstrucción inicial guía al modelo de difusión
Las características estructurales se convierten primero en una imagen aproximada mediante una técnica llamada Deep Image Prior. El resultado funciona como un boceto: conserva parte de la distribución de formas y la estructura general, pero todavía no es una imagen final detallada.
Luego entra en acción un modelo de difusión. Estos modelos suelen comenzar con ruido y eliminarlo gradualmente hasta generar una imagen. En Brain-IT, el proceso recibe dos guías:
- la imagen inicial que aporta estructura;
- las características semánticas que indican el contenido esperado.
La difusión refina el boceto y agrega detalles, pero debe hacerlo respetando las señales inferidas desde el cerebro. En términos simplificados, la rama semántica ayuda a responder “qué hay en la escena” y la rama estructural ayuda a responder “dónde está y cómo se distribuye”.
El resultado final no es una copia directa de la actividad cerebral. Es una imagen generada a partir de representaciones visuales intermedias predichas por el modelo.
El modelo también aprende el camino inverso
El equipo incorporó otro componente importante: un encoder imagen→fMRI. Este modelo recibe una imagen y predice qué respuesta cerebral produciría, aproximadamente, en cada vóxel.
Eso permite ampliar el entrenamiento. Los investigadores pueden tomar imágenes que nunca fueron mostradas a una persona dentro del escáner, utilizar el encoder para generar una respuesta cerebral sintética y luego entrenar el decodificador para reconstruir la imagen original a partir de esa respuesta estimada.
El procedimiento funciona como un diccionario de dos direcciones:
imagen → actividad cerebral estimada → imagen reconstruida
Las respuestas sintéticas no reemplazan una medición real. No son evidencia de que una persona haya visto esas imágenes. Su utilidad es permitir que el modelo practique con muchas más imágenes y aprenda representaciones visuales con menos pares reales de fMRI.
Qué encontraron en las pruebas
En las evaluaciones realizadas con el Natural Scenes Dataset, Brain-IT obtuvo mejores resultados que varios métodos anteriores en métricas de similitud visual y semántica.
Con el conjunto completo de datos, el paper informa una correlación de píxeles de 0,386 y una puntuación SSIM de 0,486. PixCorr mide cuánto se parecen los valores de los píxeles entre la imagen original y la reconstrucción. SSIM evalúa similitud estructural. También obtuvo mejores valores en métricas basadas en redes visuales y en CLIP que modelos como MindEye2 y MindTuner en la comparación presentada por los autores.
Estas cifras no significan que la reconstrucción sea idéntica. Una correlación de píxeles de 0,386 deja mucho margen para diferencias, y SSIM tampoco garantiza que cada detalle haya sido recuperado. Las métricas indican que, en promedio, las imágenes mantienen más semejanza con las originales que las producidas por los métodos comparados.
El resultado más llamativo se relaciona con la adaptación a nuevos participantes. Según el trabajo, Brain-IT logra con una hora de datos específicos de una persona resultados comparables a los que otros métodos obtienen después de entrenarse con unas 40 horas. En experimentos adicionales, los autores reportan reconstrucciones visualmente significativas con 15 minutos de datos del nuevo sujeto, equivalentes a unos 450 ejemplos de fMRI en su protocolo. El paper completo detalla las métricas y las comparaciones.
La mejora no es “leer la mente” sin entrenamiento
La capacidad demostrada es más acotada que lo que sugiere el titular.
Brain-IT reconstruye imágenes que las personas están mirando durante una tarea controlada. Necesita un escáner fMRI, un modelo previamente entrenado y datos de calibración de la persona nueva. No se ha demostrado que pueda recuperar pensamientos espontáneos, recuerdos, intenciones o conversaciones internas.
Tampoco se ha demostrado aquí que pueda reconstruir sueños o imágenes imaginadas. La imaginación visual no es simplemente mirar una imagen sin que exista un estímulo externo: puede ser más débil, más variable y estar mezclada con recuerdos y conceptos abstractos.
Además, la imagen final puede contener detalles completados por el modelo generativo. Si la actividad cerebral solo determina con claridad que hay una persona junto a un objeto, la difusión puede producir rasgos específicos que parecen convincentes pero no estaban realmente presentes en la señal.
Qué cambió frente a los métodos anteriores
Brain-IT no inventó la reconstrucción de imágenes desde fMRI. Trabajos anteriores ya utilizaban redes profundas, espacios de características como CLIP y modelos de difusión. MindEye2, por ejemplo, también había mostrado que compartir información entre participantes podía reducir la cantidad de datos necesarios para adaptar el sistema a una persona nueva.
El cambio de Brain-IT está en cómo organiza y utiliza esa información. En vez de tratar cada escaneo como una unidad global, agrupa vóxeles con funciones parecidas y permite que esos grupos interactúen. En vez de predecir una sola representación general de la imagen, intenta producir características localizadas. Y en vez de dejar que la difusión genere toda la estructura desde una guía semántica, le proporciona una reconstrucción inicial basada en características de bajo nivel.
Por eso la mejora buscada no es solo reconocer que aparece un perro o una persona. Es conservar mejor la composición: la posición de los objetos, el color, las formas y las relaciones espaciales.
Por qué importa
La importancia inmediata es técnica. Si una IA puede adaptarse a una persona nueva con menos tiempo dentro del escáner, la reconstrucción visual se vuelve más práctica para investigaciones que no pueden recopilar decenas de horas de datos por participante.
También puede ser útil como herramienta para estudiar cómo se distribuye la información visual en el cerebro. El encoder imagen→fMRI permite probar de manera controlada qué ocurre cuando se cambia una propiedad de una imagen. Por ejemplo, se puede comparar una versión en color con otra en blanco y negro y observar qué grupos funcionales cambian en la predicción.
A más largo plazo, estos modelos podrían contribuir a interfaces cerebro-computadora, a la investigación de trastornos de la conciencia o al estudio de la imaginación visual. Pero esas aplicaciones todavía requieren resolver problemas de precisión, velocidad, privacidad y validación clínica.
La tecnología también plantea una cuestión de protección de datos. Una reconstrucción cerebral no es una fotografía neutral: es una inferencia producida por un modelo entrenado sobre una persona y un contexto concretos. Sería necesario establecer quién puede recopilar esos datos, cómo se almacenan y qué límites existen para utilizarlos fuera del consentimiento original.
Lo establecido y lo que sigue abierto
Está establecido que Brain-IT puede reconstruir, a partir de fMRI, imágenes estáticas que una persona está viendo en un entorno experimental, y que su combinación de grupos funcionales, atención, características semánticas, estructura visual y difusión supera a varios métodos anteriores en las pruebas del Natural Scenes Dataset. También está establecido que puede adaptarse a un nuevo participante con bastante menos datos que los enfoques personalizados tradicionales.
Sigue abierto cuánto de cada detalle proviene realmente de la señal cerebral y cuánto aporta el conocimiento visual previo del modelo generativo. También falta comprobar cómo funciona con otras personas, otros escáneres, imágenes fuera de la base de entrenamiento, escenas dinámicas e imágenes imaginadas. Por ahora, Brain-IT es una herramienta avanzada de decodificación visual, no un lector general de pensamientos.